题目链接:https://www.luogu.com.cn/problem/P9232
题目要求对原字符串反转一段后比原来小的情况的总和
先看数据规模:20%的评测用例1<=n<=100,40%的评测用例1<=n<=1000,全部用例1<=n<=5000
这里有个隐含前提:反转之后串长不变,所以字典序比较等价于数值比较,可以直接用<比
一个很自然的想法就是直接枚举所有情况,毕竟区间只有约n^2个
于是就可以从l=2时开始遍历,逐步增加到l=n
之后用字典序对原字符串和反转后的字符串比较
#include <bits/stdc++.h>
using namespace std;

int main(){
    string s;
    int ans = 0;
    cin>>s;
    int n = (int)s.length();
    for(int len = 2;len<=n;len++){
        for(int i = 0;i+len<=n;i++){
            string t = s;
            reverse(t.begin()+i,t.begin()+i+len);
            if(t<s) ans++;
        }
    }
    cout<<ans;
    return 0;
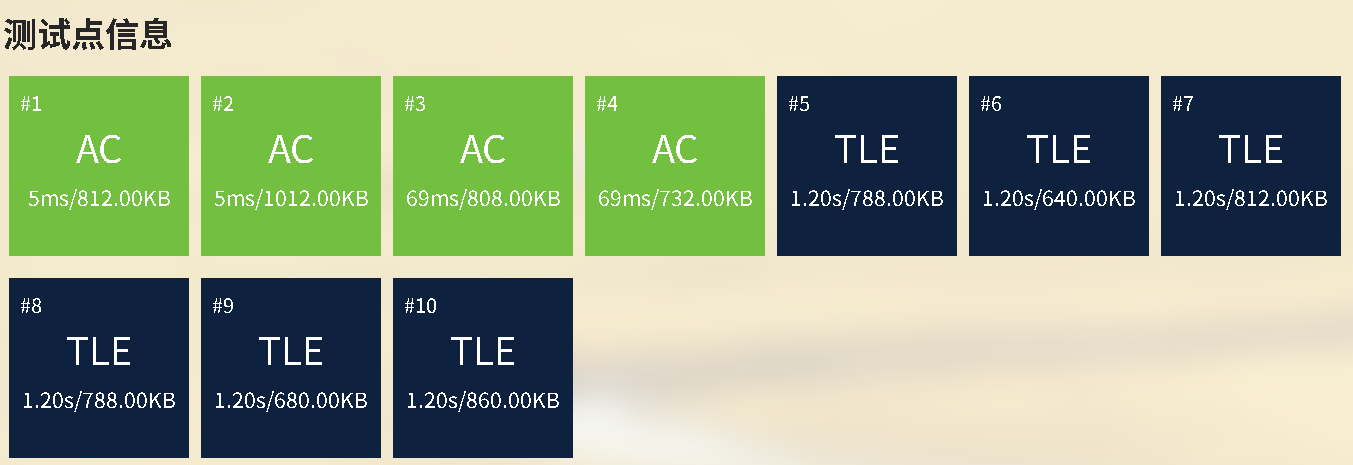
}但是按照这样写的话只能拿到40分:外层枚举区间是n^2,但每一轮还要把原串拷贝一份(O(n)),再整个比一遍(O(n)),总复杂度是n^3而不是n^2
n=1000时大约是10^9级别的字符操作,勉强能过(这就是那40%的用例);n=5000时直接涨到10^11,必然TLE
那么如何优化这个算法呢?
注意到在比较过程中,实际上只需看区间两端,再从两端同时往中间扫
反转之后,区间的左端i上放的是原来的s[j],从左往右逐位比,第一个可能不同的位置就是i,比的是s[j]和s[i]
例如123456和654321,第一位就分出了大小;如果第一位相同就继续往里比,直到第一对不相同的字符为止(回文串则全程打平)
也就是说
s[i] > s[j] → 反转后变小
s[i] < s[j] → 反转后变大
相等 → 结果等于内部区间 [i+1, j-1] 的结果
所以可以单独开一个数组进行存储
int ans = 0;
vector<vector<char>> f(n, vector<char>(n, 0));  // f[i][j]:反转 s[i..j] 后是否更小
for (int len = 2; len <= n; len++)
{
    for (int i = 0; i + len <= n; i++) {
        int j = i + len - 1;
        if (s[i] == s[j]) // 两端相同,往里看
            f[i][j] = (len > 2) ? f[i+1][j-1] : 0;
        else
            f[i][j] = (s[i] > s[j]); // 大的那个被挪到了前面 → 变小
        ans += f[i][j];
    }
}
cout<<ans;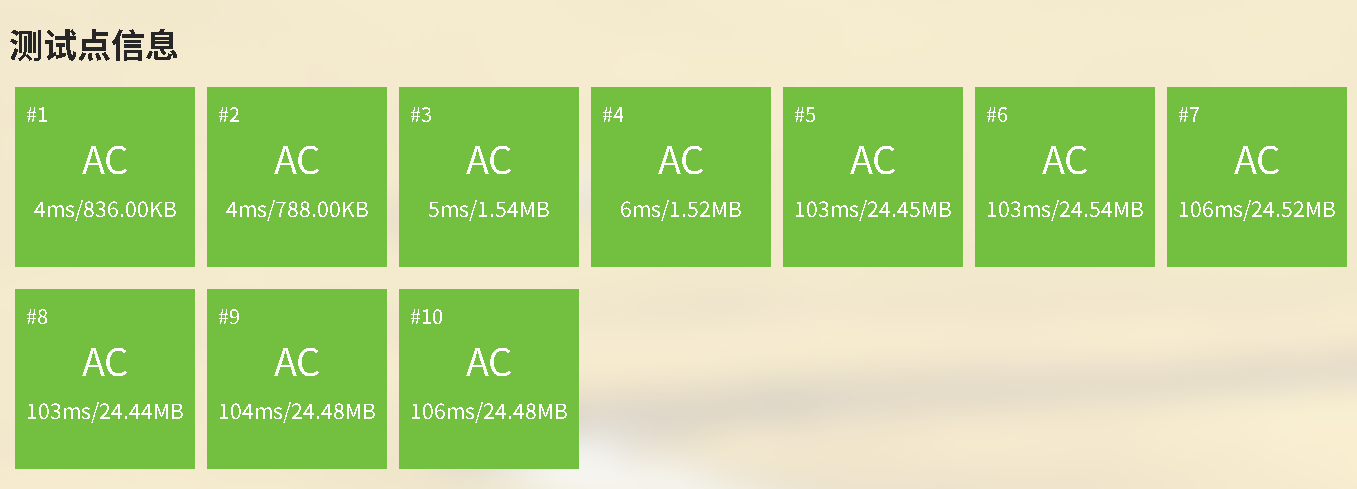
附件下载
- P9232-更小的数.cpp(703 B · 27 行)
- P9232-蓝桥杯2023-更小的数.md(2 KB · 77 行)